01 / 描述现象
CPU 才用了 12.5%,968 个仿真却在排队。
假设集群有 256 个 CPU,也配置了 256 个 Slot。你一次提交 1,000 个单线程仿真,每个却申请了 8 个 Slot。结果只有 32 个在跑,剩下 968 个一直等。
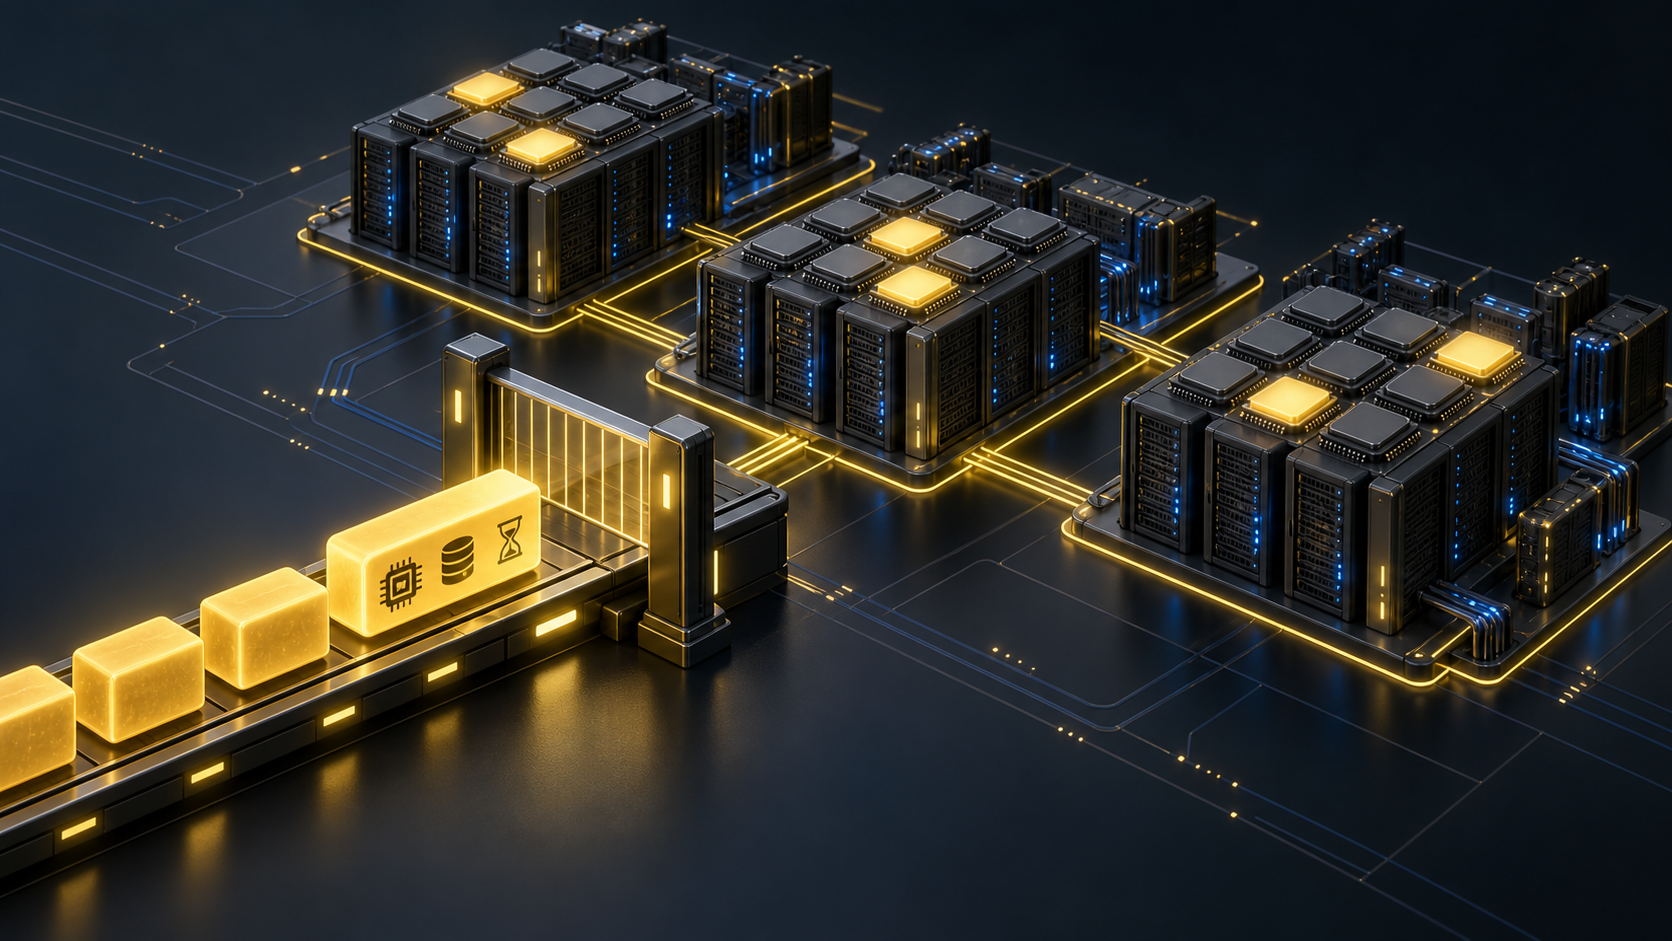
打开监控,CPU 利用率只有 12.5%。问题在哪?调度器按申请分出了 8 个,程序实际只用了 1 个。下面这张图,把“申请了多少”和“用了多少”分开看。
把这笔账算清楚
为什么“额度满了,CPU 却很空”?
32 个单线程仿真,只忙了 32 个 CPU。
32 × 1 ÷ 256 = 12.5%。这里假设每个线程都在持续计算;如果还在等 I/O 或许可证,利用率可能更低。
申请的 256 个 Slot,已经全部分出去了。
程序只用了其中一部分,也不会自动把剩下的额度退回来。后面的 968 个作业,只能继续等。
256 ÷ 1 = 256,额度不再被白占。
这是只考虑 Slot 的并发上限,不代表吞吐一定提高 8 倍。仿真并发增加后,还要看内存、许可证和文件系统能不能跟上。
示例按 1 Slot 对应 1 个 CPU、无超额分配计算。实际 Slot 上限和 Slurm 分配粒度以集群配置为准。
02 / LSF 集群
LSF:查清原因,再改提交模板。
排查路径:排队原因 → 运行作业的 Slot 占用 → 仿真进程的实际用量。
第 1 步
找一个 PEND 作业,看排队原因。
PEND_JOB=12345
bjobs -p "$PEND_JOB"
bjobs -l "$PEND_JOB"
看 PENDING REASONS。如果提示 Slot 不足,例如 Not enough job slot(s),继续第 2 步。若提示内存预留、队列限制或依赖问题,直接跳到文末对应原因。查不到编号时,先确认集群、权限和作业是否已结束。[1]
第 2 步
找同一批的 RUN 作业,确认是不是每个都申请了 8 个。
bjobs -r -u "$USER"
RUN_JOB=12340
bjobs -l "$RUN_JOB"
bhosts -l eda-node01对照三处:提交脚本有没有 bsub -n 8;作业详情里的请求/已分配 Slot 数是不是 8;执行主机的 MAX(容量)、RUN(运行占用)和 RSV(预留)是什么情况。详细字段随版本变化,部分版本显示 Allocated 8 Slot(s)。[2][15]
如果大量同类仿真都占 8 个,主机 Slot 又确实分满了,就继续查:程序真能用上 8 个吗?
第 3 步
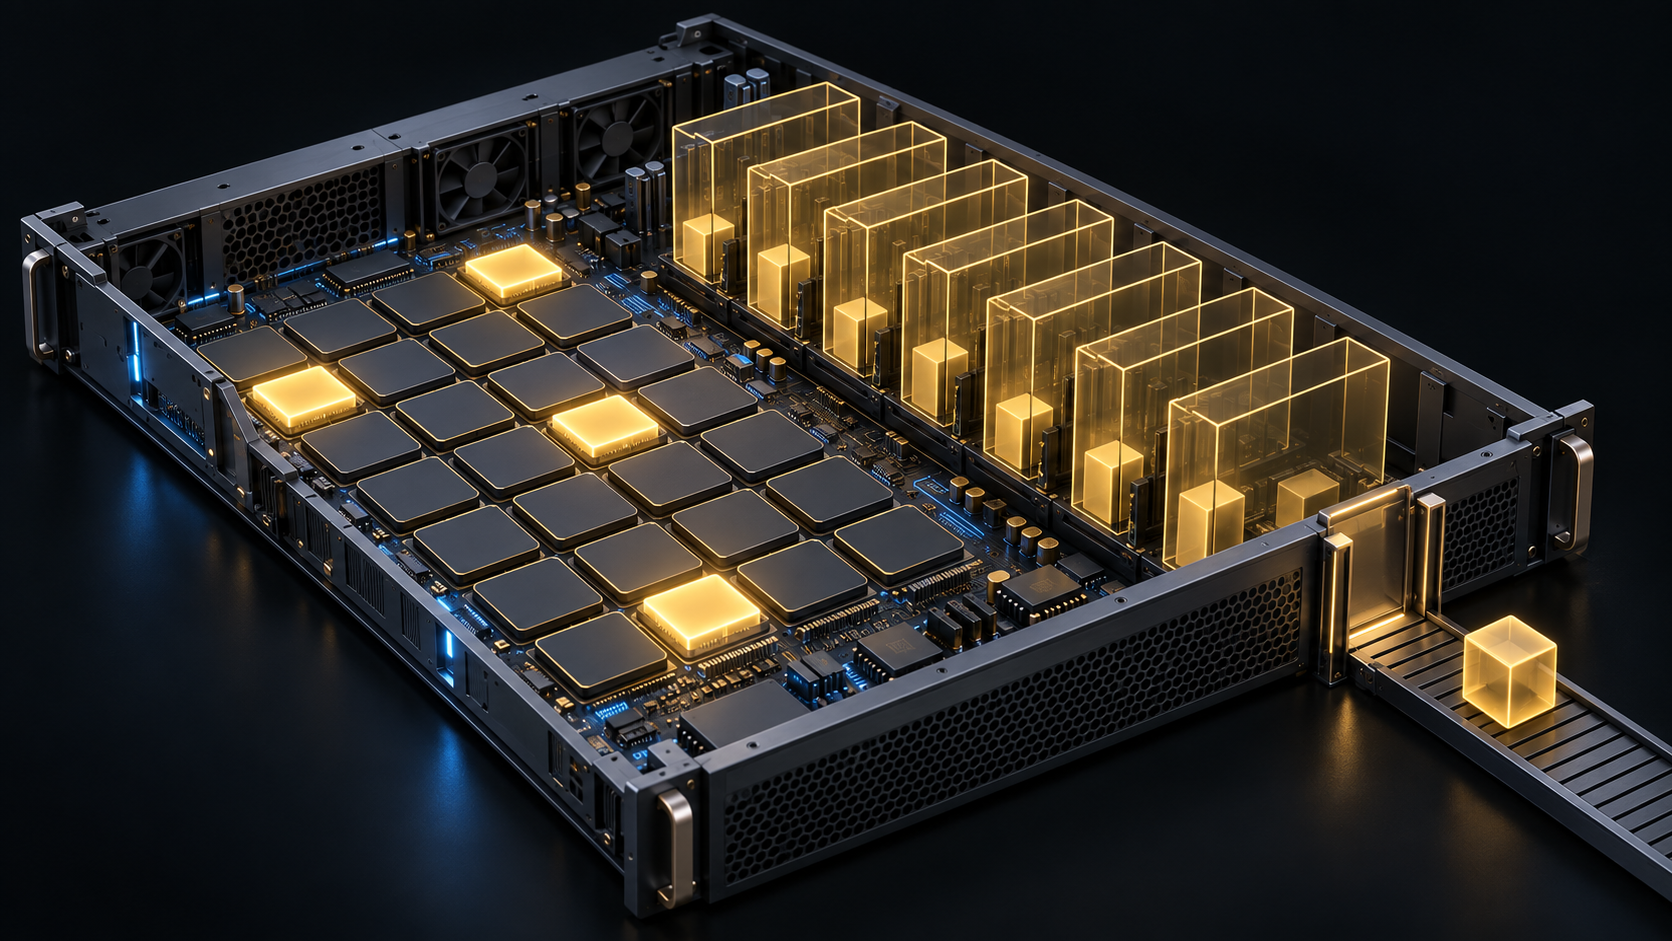
到执行节点,看仿真进程实际用了几个线程。
ps -u "$USER" -o pid,ppid,pcpu,etime,args
SIM_PID=23456
top -H -p "$SIM_PID"在主要仿真阶段连续观察几次。若一个线程长期接近 100%,其他线程几乎不动,再对照仿真启动参数和日志确认是否为单线程。这里按 top 的 Irix 模式计算:线程 100% 约等于用满一个逻辑 CPU;关闭该模式后百分比口径不同。[16]
别只盯着启动脚本的 shell。如果仿真启动了子进程,还要把这些进程算进去。也别拿读文件、等 license 时的一帧低负载,就认定它只需要 1 个。
解决办法
确认只用 1 个,再把模板里的 -n 8 改掉。
# 原来的写法:bsub -n 8 ./run_sim.sh
# 确认单线程后,后续作业改成
bsub -n 1 ./run_sim.sh先用少量代表性用例验证,比较结果、用时和内存峰值,再改批量回归模板。如果确实需要 8 线程,就检查仿真器的并行选项是否开启、当前阶段是否支持;只有 -n 8 不会让程序自动并行。
注意:若内存按任务预留,减少 -n 也可能减少总预留。CPU 改成 1,不等于内存也能除以 8。内存按作业峰值和余量重新核对。模板修改只影响后续提交,已运行的作业不会自动归还 Slot。[4]
03 / SLURM 集群
Slurm:重点查这两个申请参数。
排查路径:Reason → 任务数与 CPU 分配 → 线程和作业统计。
第 1 步
先看 Reason,是缺资源还是被策略挡住。
PEND_JOB=12345
squeue -j "$PEND_JOB" -o "%.18i %.12T %R"
scontrol show job "$PEND_JOB"Resources:继续查资源。Priority:有更高优先级作业;QOSGrp* / AssocGrp*:检查对应限额;Dependency:检查前置作业。后几类先看文末表格,不要都归到“CPU 不够”。Reason 可能只显示当前遇到的一项原因。[7]
第 2 步
检查运行作业,有没有“分了 8 CPU,只跑一个单线程进程”。
squeue -u "$USER" -t RUNNING
RUN_JOB=12340
scontrol show job "$RUN_JOB"
scontrol show node eda-node01
sinfo -N -p compute -o "%N %t %C"
作业看 NumCPUs、NumTasks、CPUs/Task 和 TRES;节点看 CPUAlloc、CPUTot。sinfo 的 %C 依次是“已分配 / 空闲 / 其他 / 总量”,不是 CPU 使用率。[10][9]
--ntasks 是任务数,--cpus-per-task 是每个任务申请的 CPU 数。单进程仿真要查两种写法:--ntasks=1 --cpus-per-task=8,或者误写 --ntasks=8。后者不会自动把单线程程序加速;用 srun 启动时,还可能跑出多份相同仿真。[12]
第 3 步
看线程,再用已完成作业的统计交叉确认。
运行中的仿真,同样在执行节点用 top -H -p 仿真PID 看线程,具体看法见 LSF 第 3 步。已经正常结束的作业,可以补查:
DONE_JOB=12330
sacct -j "$DONE_JOB" \
--format=JobID,State,AllocCPUS,Elapsed,TotalCPU例如作业总行显示:分配 8 CPU,运行 1 小时,TotalCPU 约 1 小时,相当于这段时间平均只用了约 1 个 CPU,申请利用率约为 1 ÷ (1 × 8) = 12.5%。
用作业总行计算,别再把 .batch 等步骤重复加上。CPUTime 是分配 CPU 数乘运行时长,不能当实际用量;统计缺失、作业被杀或存在阶段性并行时,也不能只凭这个平均值决定减到 1。[17]
解决办法
单进程、单线程仿真,把申请也改成 1。
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --cpus-per-task=1同样先跑少量用例,再更新批量回归模板。--mem-per-cpu 会随 CPU 数影响总内存申请;单节点仿真需要固定总内存时,可以按峰值改用 --mem,两种写法不要同时设置。[12]
改完若 AllocCPUS 仍大于预期,再查 --exclusive、整节点分配和站点策略。Slurm 最终分配的 CPU 数,不一定等于脚本中的最小申请数。[11]
再看一个例子:空闲 CPU 分散在不同节点
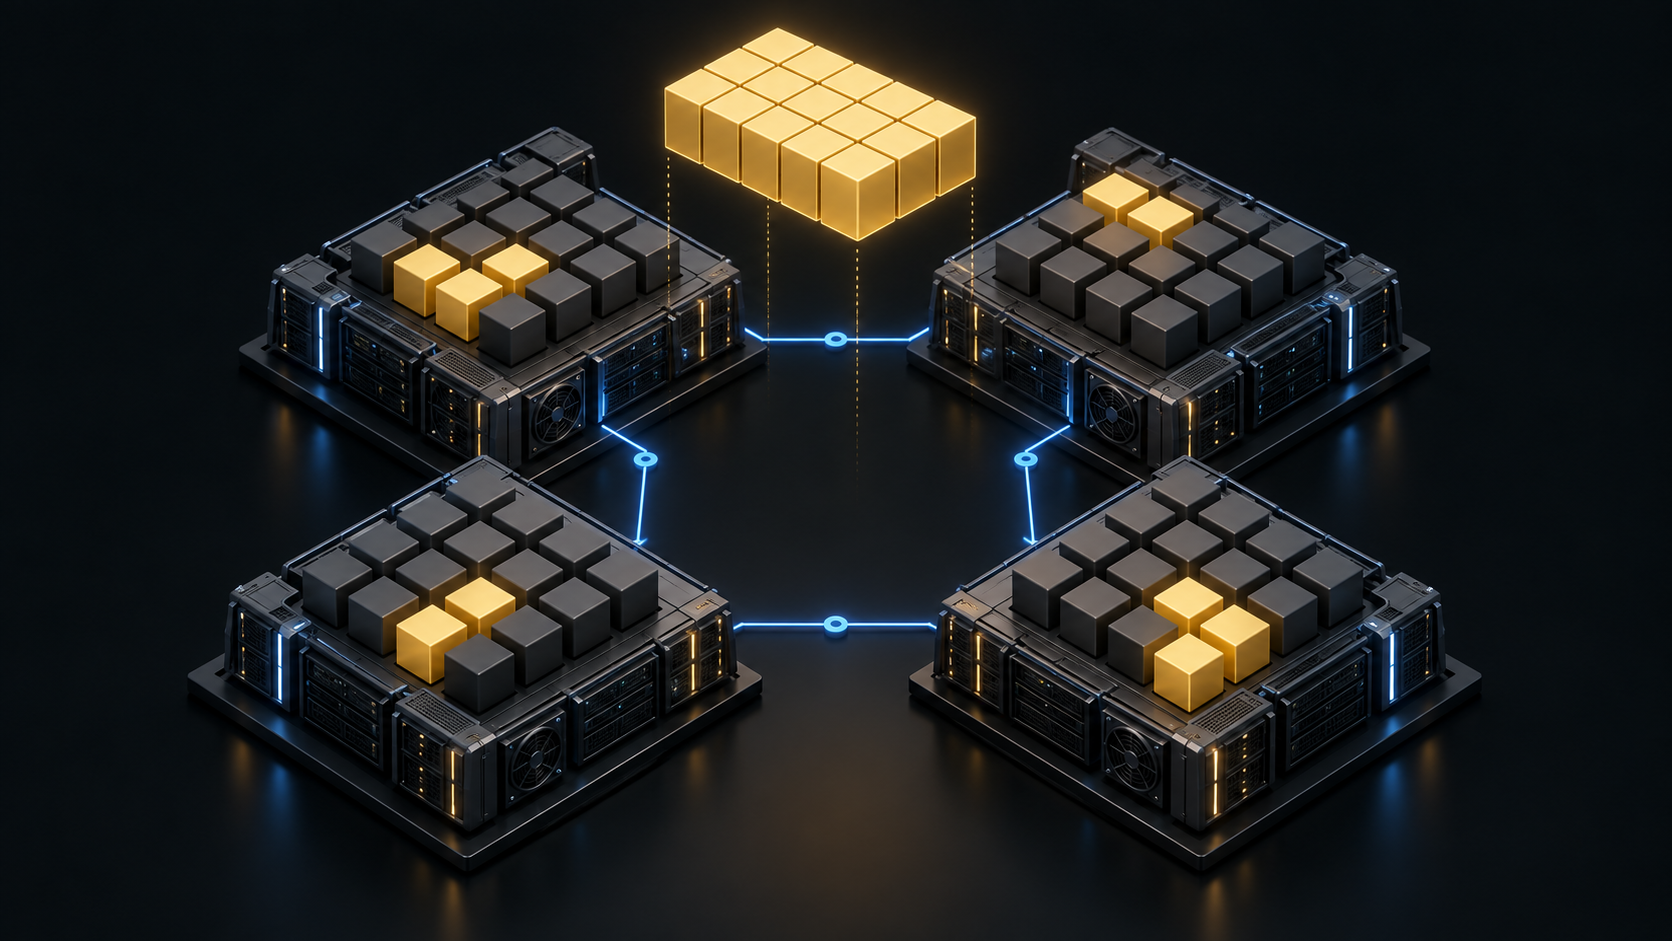
A 剩 8,B 剩 8,为什么要 16 个还得等?
现象:两个节点合计剩 16 CPU,单节点 16 线程仿真仍在排队。
排查路径:用 scontrol show job 确认请求是 --nodes=1 --ntasks=1 --cpus-per-task=16,再用 sinfo -N 逐节点看空闲量。A、B 各剩 8,任一节点都放不下。
解决办法:等一个节点空出 16 CPU,或改投有权限使用、容量满足要求的分区。若仿真支持更少线程,可以测完性能后同步调整线程数和 CPU 申请;只有程序支持跨节点时,才考虑跨节点运行。
04 / 不是申请多了,就按原因继续查
其他几种情况,分别查什么?
| 遇到什么情况 | LSF 怎么查 | Slurm 怎么查 | 接下来怎么办 |
|---|---|---|---|
| 内存不够分 | bjobs -l 看 rusage;bhosts -l 看主机资源 | scontrol show job 看 ReqTRES;show node 看 RealMemory / AllocMem | 按每作业峰值和余量检查申请。物理空闲内存多,不等于调度器还能分。 |
| 队列/分区或用户限额 | bqueues -l 队列名;对照原因里的限制对象 | scontrol show partition 分区名;看 QOS / Assoc 原因 | 把命中的限制和作业 ID 给管理员,确认限额或额度释放时间。 |
| 优先级/预留 | 对照排队原因和队列的 fairshare 等设置 | 启用多因子优先级时用 sprio -j 作业ID;结合 Priority、预留和回填策略[18] | 确认是否要等高优先级作业或预留。若申请时长远超实际用时,可按历史记录修正,增加被回填的机会。 |
| 依赖、挂起或未到开始时间 | bjobs -l 看状态与依赖条件 | show job 看 Dependency、BeginTime 或 Hold 原因 | 先查前置作业是否成功、条件是否写错;加 CPU 解决不了。 |
| 等待许可证 | 先确认原因是否指向已接入的 license 资源 | Reason 为 Licenses 时查调度器许可证资源 | 若作业已经 RUNNING,却在日志里等 license,应查仿真日志和许可证服务。 |
队列规则、回填与许可证说明见 [6]、[7]、[13]、[14]。资源查询应以作业有权限使用的节点为范围。
改完以后,看这三件事。
每个作业的申请降下来了吗?同时运行的仿真变多了吗?相同一批用例的总完成时间有没有缩短?同时留意失败率、内存和许可证等待,别只看 CPU 曲线变高了。
资料来源
参考资料
依据 IBM LSF 10.1、SchedMD 和 Linux 官方手册整理,查阅日期 2026-09-14。数值为教学示例,图片为 AI 示意图;命令未在真实集群执行。
- IBM LSF 10.1 · 查看排队原因
- IBM LSF 10.1 · bhosts 命令参考
- IBM LSF 10.1 · 资源要求字符串
- IBM LSF 10.1 · RESOURCE_RESERVE_PER_TASK
- IBM LSF 10.1 · LSF_UNIT_FOR_LIMITS
- IBM LSF 10.1 · Pending job management
- SchedMD · Job reason codes
- SchedMD · squeue
- SchedMD · sinfo
- SchedMD · scontrol
- SchedMD · CPU management
- SchedMD · sbatch
- SchedMD · Scheduling configuration
- SchedMD · Licenses guide
- IBM LSF · Slot 与 CPU 使用详情
- Linux · top 线程与 CPU 百分比
- SchedMD · sacct 统计字段
- SchedMD · sprio 优先级查询