1. WeKnora 是什么:把 EDA 文档变成可用的知识
WeKnora 是腾讯开源的、基于大语言模型的知识管理框架,面向文档理解、语义检索与智能问答。可以从官网了解产品,也可以按需自行部署。
它把文档解析、索引、检索、模型回答和知识管理串在一起。对研发团队来说,输入可以是工具手册、内部使用说明、常见报错记录和已经审阅的解决方案,输出则是有资料依据的问答,以及可持续维护的知识页面。
RAG:带着问题查资料,再组织答案
RAG 即检索增强生成。提出问题后,系统先从指定知识库找出相关内容,再把这些材料交给模型生成回答。检索结果和引用让工程师可以沿着答案回到原文。
这很适合 EDA 中有明确对象的查询,例如“Verdi 如何加载 FSDB”“某个选项用在什么场景”。工具名、参数名和错误码需要精确匹配,自然语言描述的问题又需要语义理解,因此关键词检索与向量检索可以相互补充。
Wiki:把查过的资料组织成知识页面
Wiki 模式更进一步:文档入库后,WeKnora 可以提取其中的实体和概念,生成带出处的 Markdown 页面,再通过链接把页面组织起来。工程师既能提问,也能沿着概念关系浏览资料。
例如,Verdi 文档中的 FSDB、KDB、波形加载、设计数据库和 Tcl 脚本并不是孤立的词。把它们连接起来,便于理解“一个选项解决哪一部分问题”“下一步还应该查什么”。这些页面也能人工编辑,并保留版本历史。官方 Wiki 说明介绍了生成、浏览和回滚方式。
Agent:需要时多查几步
遇到需要反复检索、阅读多份材料的问题,Agent 可以分步调用检索与工具,逐步组织答案。RAG 适合直接查问,Wiki 适合整理和浏览,Agent 适合多步分析;三种能力围绕同一批资料配合使用。
搭建 EDA 知识库时,我更看重这条路径:先把可靠资料放进去,再让检索和 Wiki 帮助研发人员理解、复用它们。 数据本身的质量、版本标记和后续维护,仍然决定知识库能走多远。
2. 基本核心企业级功能:研发团队需要什么
文档处理与检索可以按资料调整
WeKnora 支持 PDF、Word、Markdown 等多种文档格式,并提供解析、分块、索引等处理环节。对扫描件和图文复杂的材料,需要选择合适的解析能力,并检查实际解析结果。
检索侧支持关键词与向量等策略,也可以配置 Rerank 模型对候选结果重排。长手册可以结合父子分块保留更多上下文;分块内容还能编辑、查看历史并重新建立索引。这些能力为改善召回质量提供了手段,具体效果仍需用自己的问题集验证。
EDA 手册对版本和语境很敏感。同一命令在不同版本中可能有变化,因此应在文件名或资料说明中保留工具版本,抽查命令、表格、脚本段落有没有被截断,再决定是否扩大导入范围。
Wiki 有出处,也能维护
Wiki 的价值在于把知识组织起来。页面可以相互链接、回读源资料,发现错误后能够修订;版本历史与回滚则让维护过程有记录。
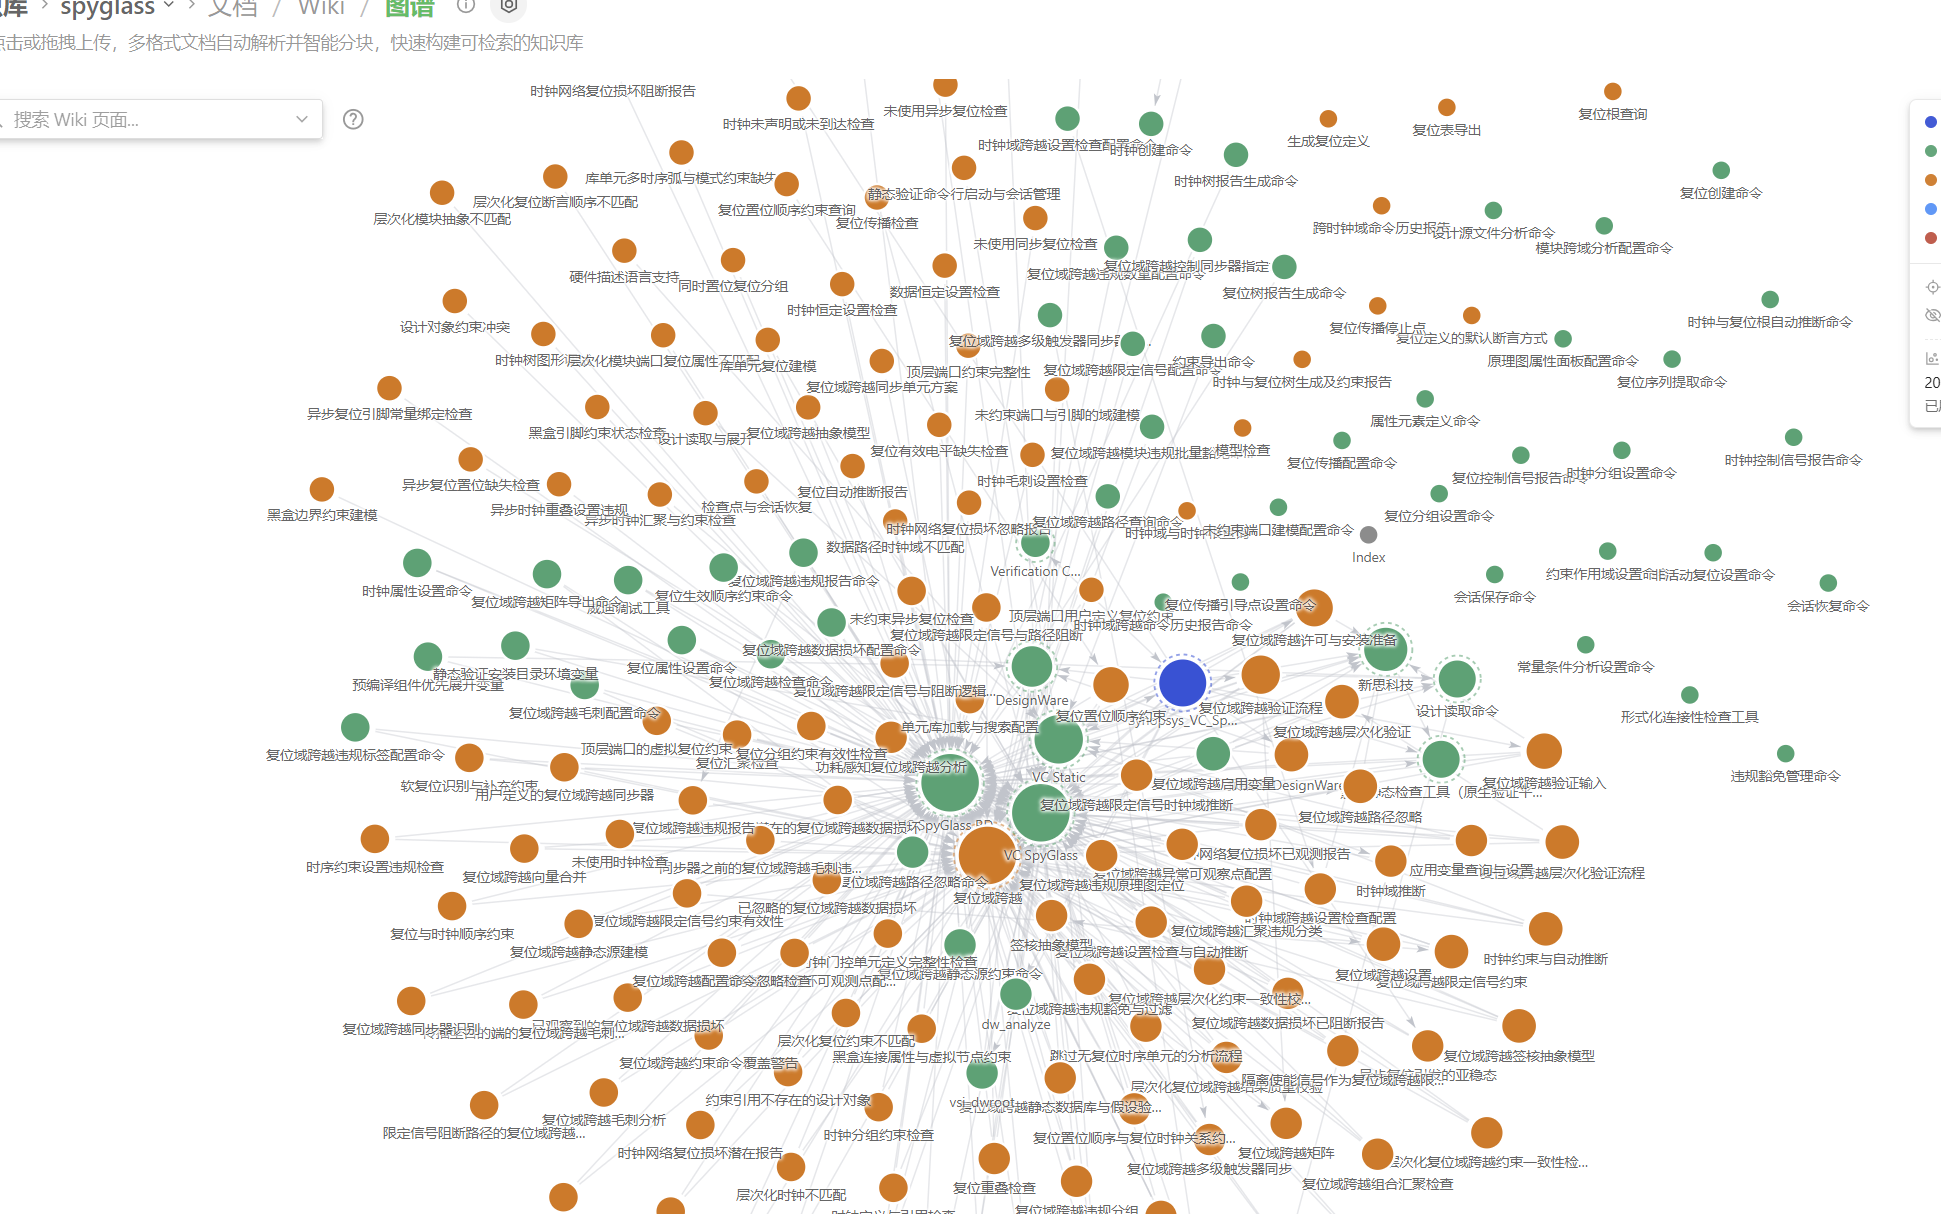
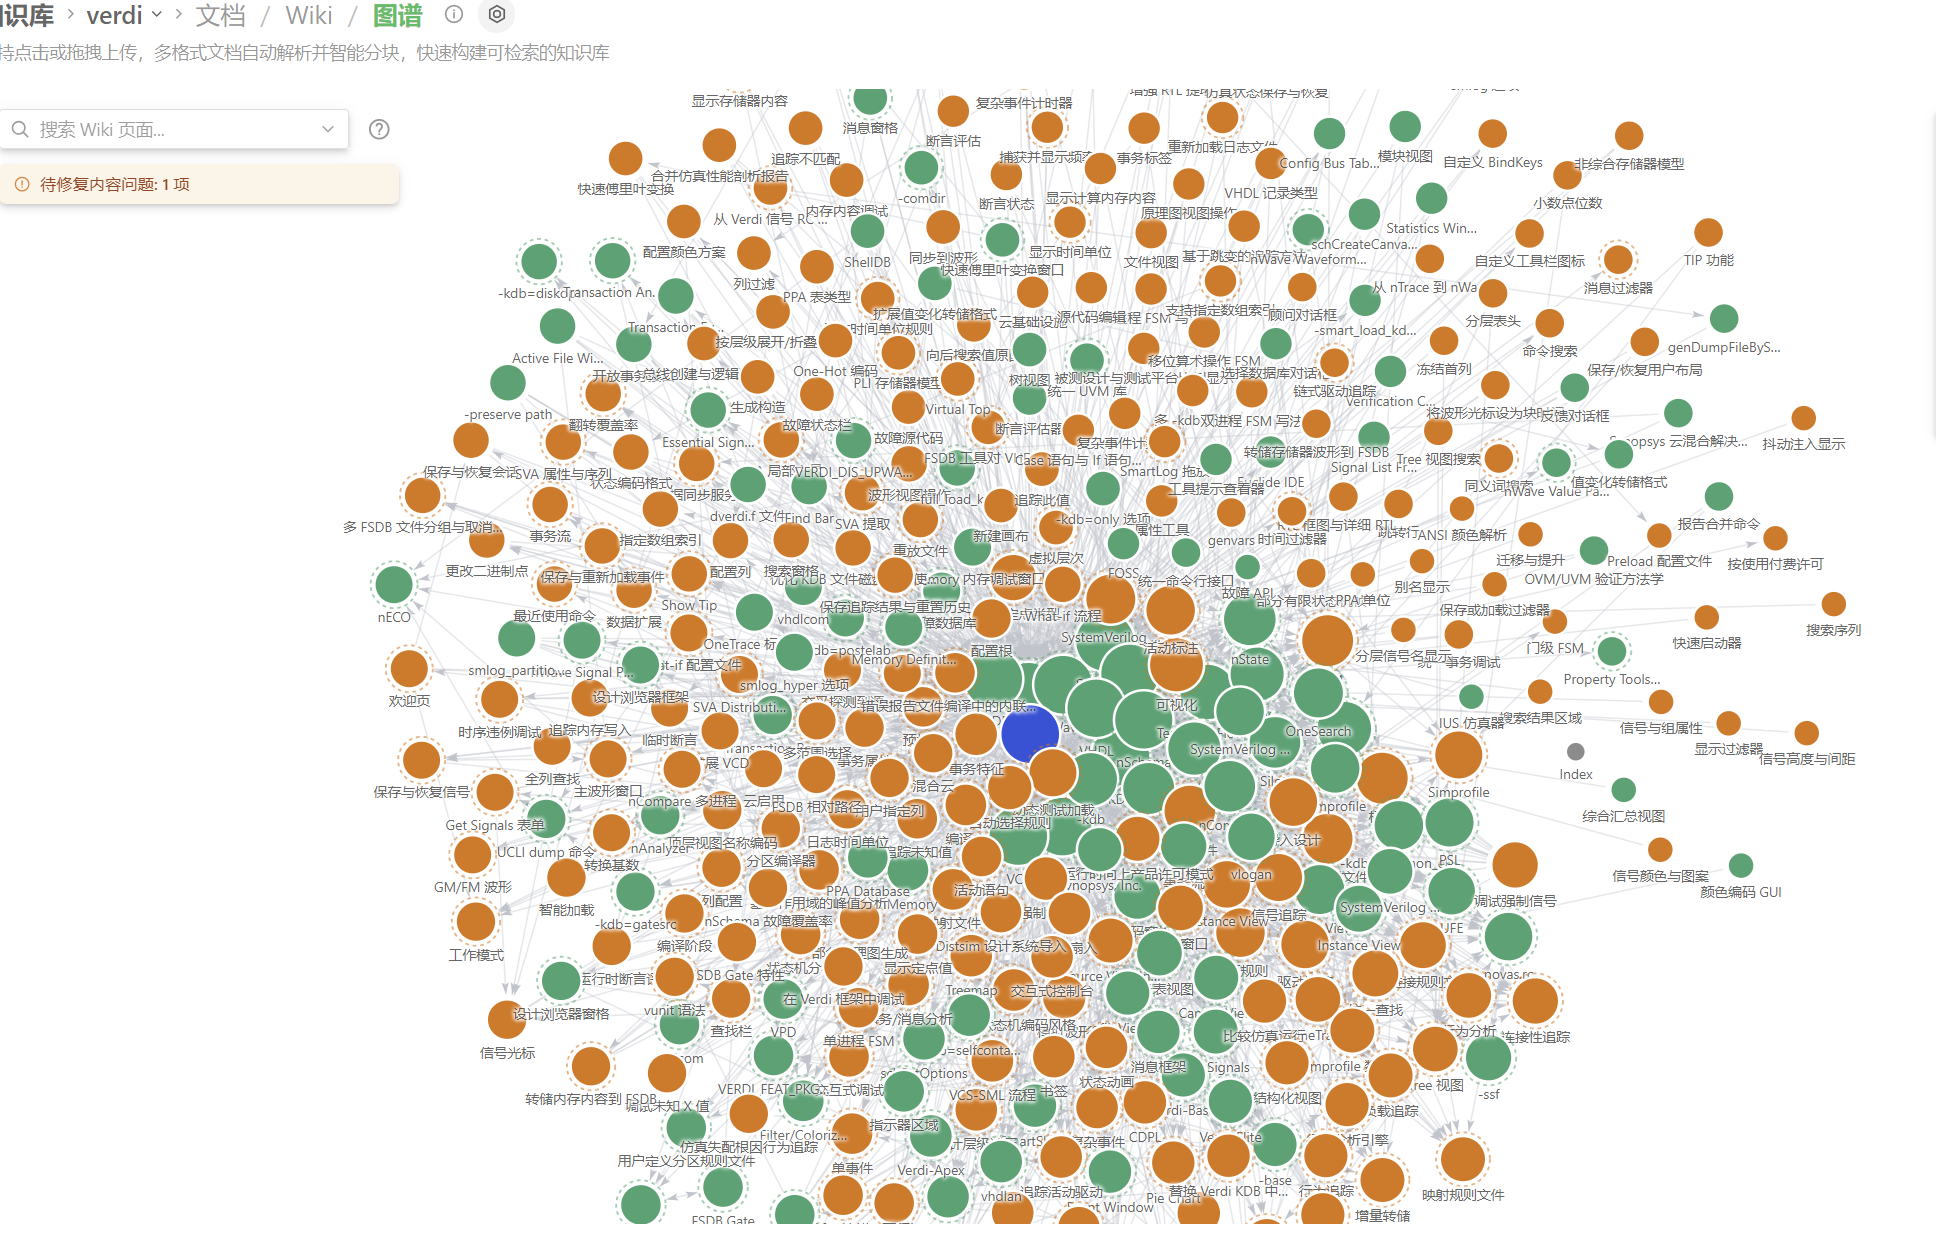
界面的 Wiki 图谱展示的是知识页面之间的链接关系。它与可选的实体关系检索、GraphRAG 是需要区分的能力,使用 Wiki 不需要先把 Neo4j 当成必装组件。本次截图中的图谱,用来观察资料组织结果,不作为回答正确率的证明。
空间、权限与审计支持团队使用
工作空间提供资料和协作的边界,成员可分配 Owner、Admin、Contributor、Viewer 等角色。团队可围绕维护者、上传者和使用者分工,再按授权需要共享知识库。
知识库活动记录、审计以及任务处理状态,有助于追踪资料更新和排查失败。身份认证解决“谁能登录”,空间与资源权限解决“登录后能访问什么”,两层需要分别配置。官方认证与授权说明给出了具体机制。
模型、数据源与部署方式可以选择
WeKnora 支持多种模型服务和本地模型接入,也支持自托管部署。文档、索引和应用可以部署在自有环境;如果选择外部模型接口,发送给模型的内容仍会经过该服务,因此要按资料边界选择模型与接口。
产品支持飞书知识库、飞书云盘等数据源接入,也提供 IM 问答入口。这里介绍的是官方能力,本文的试用截图来自已导入的 SpyGlass 与 Verdi 资料,不把飞书自动同步写成本次已经验证的结果。
3. 部署步骤:先跑通文档、模型和问答
准备环境与固定版本
本次部署手册记录的环境是 Rocky Linux 9.7、8 核 CPU、约 32 GB 内存,使用 Docker 与 Compose。这个配置是本次环境记录,不是最低要求,也不包含在同一台机器运行大模型所需的资源。
新环境先准备 Git、Docker Engine 和 Compose 插件,检查磁盘空间及已有服务。下面命令用于全新目录;已有部署不要重新初始化或覆盖原配置。
git clone --branch v0.8.0 --depth 1 \
  https://github.com/Tencent/WeKnora.git weknora
cd weknora
cp -n .env.example .env
chmod 600 .env
docker --version
docker compose version
固定版本有助于让说明、配置和镜像保持一致。本次基准是 v0.8.0,不用随时变化的标签替代复现版本。
配置环境变量与持久化
编辑 .env,以下是本方案的关键选项。示例域名需要替换为自己的访问域名;使用 HTTPS 入口时,还需完成对应反向代理与证书配置。
WEKNORA_VERSION=v0.8.0
FRONTEND_PORT=8088
STORAGE_TYPE=local
RETRIEVE_DRIVER=postgres
OLLAMA_OPTIONAL=true
FRONTEND_BASE_URL=http://kb.example.com:8088
启动前必须替换模板里的数据库密码、Redis 密码、JWT_SECRET 和 SYSTEM_AES_KEY。密钥在部署机器上生成,不把真实值放进文章或截图;其中加密密钥应按此版本要求设置为 32 个 ASCII 字节,例如使用本机 openssl rand -hex 16 的结果。
数据库和上传文件使用持久卷,Redis 也应按运维方案保存必要数据。备份要同时覆盖数据库、文件和配置。已有数据时保留原 SYSTEM_AES_KEY,更换它可能导致已保存的模型等凭据无法解密;不要用删除卷的方式处理普通启动故障。
启动并检查基础服务
docker compose config --quiet
docker compose pull
docker compose up -d --no-build --pull never \
  --wait --wait-timeout 180
docker compose ps
本方案的基础服务包括 frontend、app、docreader、postgres 和 redis。先确认服务运行、相关健康检查通过,再打开页面。Web 入口之外的数据库、缓存和解析服务按实际网络方案限制访问。
可在部署机器检查后端健康接口:
curl -fsS http://localhost:8080/health
预期返回 {"status":"ok"}。页面打开、容器健康和模型问答可用是三个检查项,应该分别确认。镜像拉取失败时先检查网络与仓库可达性;容器异常时查看对应日志,不重复初始化数据库。
配置模型,导入资料并开启 Wiki
在模型设置中,先配置对话模型与 Embedding 模型,并验证接口、模型 ID 和向量维度。Rerank 可以按检索需要再配置。若使用内部模型服务,应按应用规则配置精确的可信服务白名单,同时检查容器到服务的连通性;不通过关闭保护来解决地址配置问题。
接着分别建立 SpyGlass 与 Verdi 知识库,先导入少量有代表性的资料,检查解析、分块和引用。确认命令行选项与表格没有明显丢失后,再扩展到更多文档。
在知识库“索引策略”中开启 Wiki,等待异步生成完成,再进入 Wiki 与图谱页查看。生成会调用模型,需要时间与额度;文档解析完成不一定意味着 Wiki 已全部整理完毕。若效果不理想,先检查源资料、解析质量、知识库范围和模型配置,再调整检索参数。
LDAP 接入:通过 Dex 和 OIDC 衔接企业目录
企业已有 AD/LDAP 时,可以采用下图的接入方案。箭头表示身份能力的衔接关系:用户从 WeKnora 发起登录,Dex 连接企业目录完成认证,再通过 OIDC 返回身份信息。
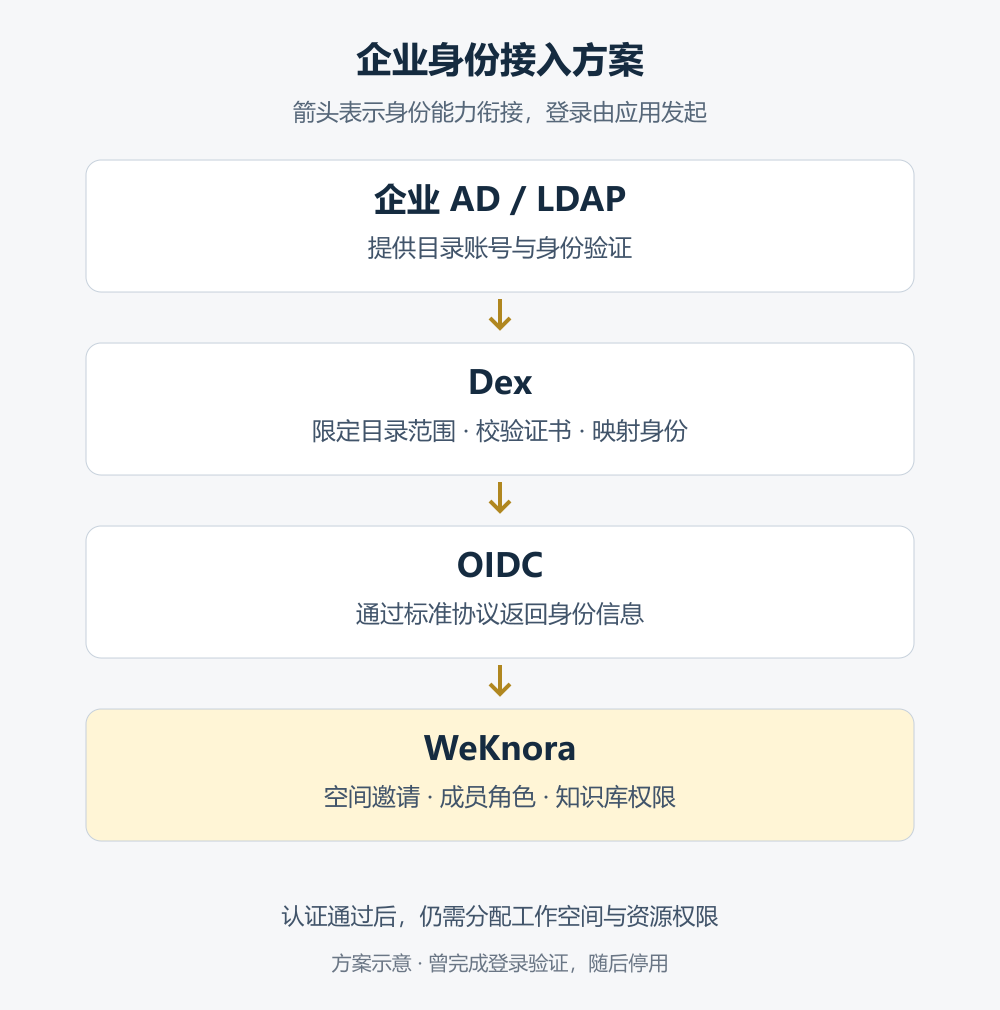
落地时需要处理目录查询范围、用户名与唯一邮箱映射、HTTPS 与目录证书校验,以及登录后的空间邀请和角色分配。LDAP 组与 WeKnora 角色不能假定自动对应。
我的部署手册记录了这条链路曾完成真实登录验证,之后已停用并恢复本地登录。这里保留方案,供需要统一身份认证的团队参考,不展开 LDAP 配置教程。连接器细节见 Dex LDAP 官方文档。
4. 试用效果:加入 SpyGlass 和 Verdi 后,回答非常好
手册开始有了可浏览的结构
导入 SpyGlass 资料后,图谱中能看到时钟、复位、约束、检查和报告等相关条目。对刚接触一套工具的人来说,这能提供一个继续查阅的入口:从当前概念出发,找到相关知识页面,再回到原始材料。
Verdi 资料也形成了类似结构,围绕波形、设计数据库、调试视图、脚本和常用选项展开。图谱越密并不代表质量越高,实际使用仍要看页面内容与引用是否准确。截图中也有待修复内容提示,说明生成后仍需要维护。
问基本参数,能整理成可查阅的答案
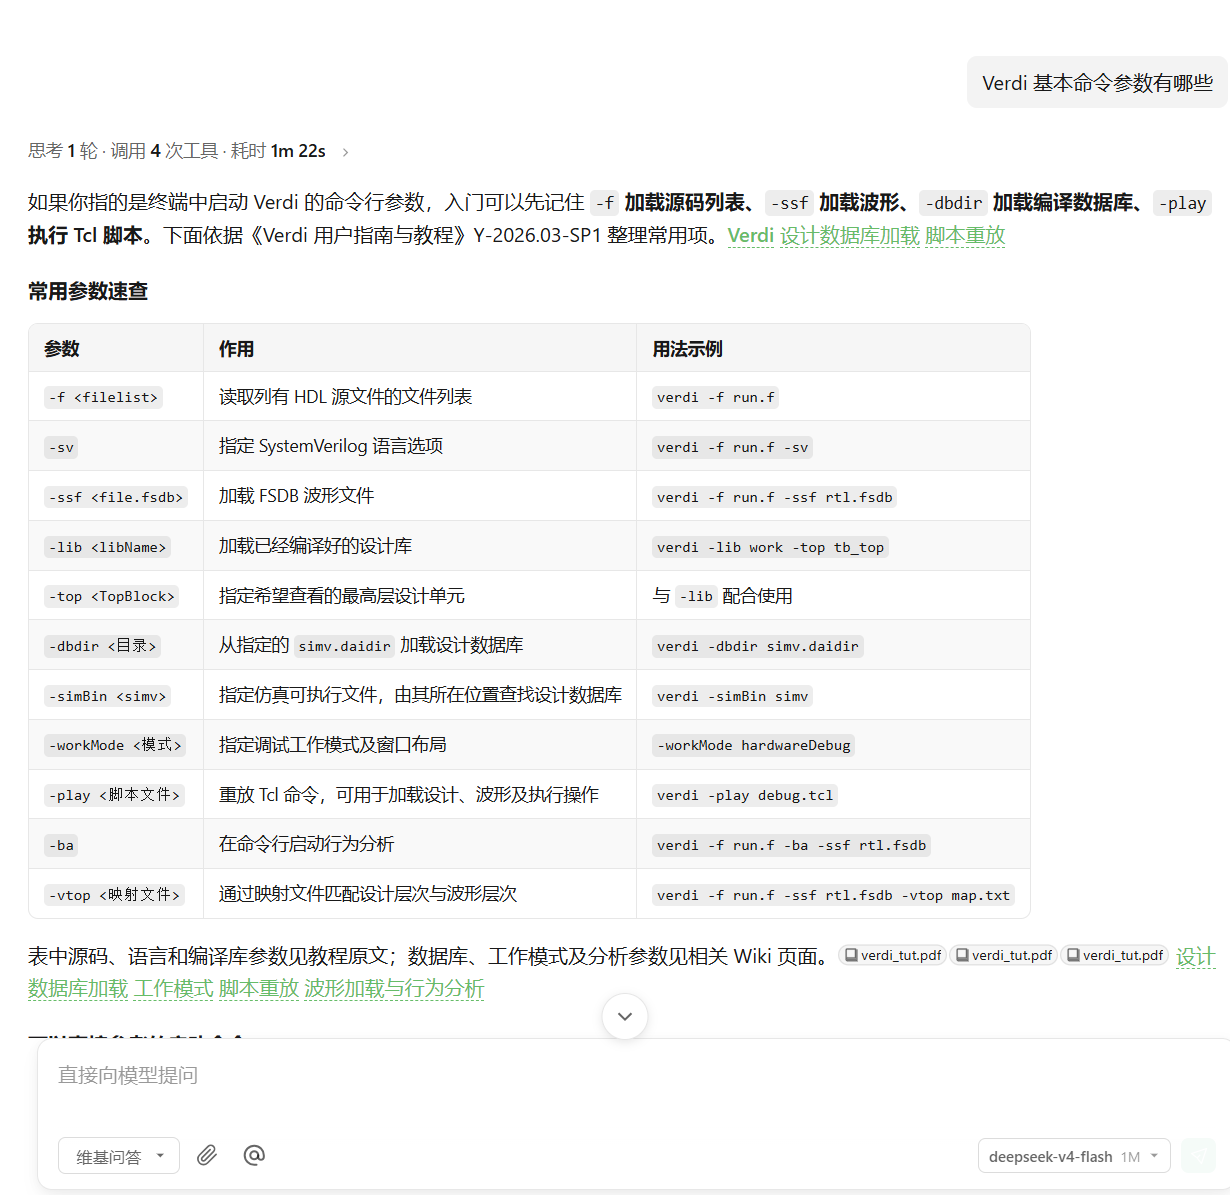
我问“Verdi 基本命令参数有哪些”,回答把常用参数整理成了“参数、作用、用法示例”的表格,并保留了文档和 Wiki 引用。
其中,-f 对应源文件列表,-ssf 对应波形,-dbdir 对应设计数据库,-play 对应 Tcl 脚本。这样的组织方式适合快速回忆参数,再沿着引用核对自己版本的具体用法。
问波形打开慢,能先拆问题再给方向
另一个问题是“verdi 打开波形慢怎么解决”。让我觉得有帮助的是,回答开头先区分加载设计数据库 KDB 和加载波形 FSDB,两部分的排查与优化方向不同。
随后,它结合资料整理波形数据规模、信号转储范围和加载方式等方向,并给出引用。截图还说明手册没有专门一章直接叫“打开波形提速”,是在汇总分散的相关机制。这比直接列出几个没有上下文的开关,更方便继续查证。
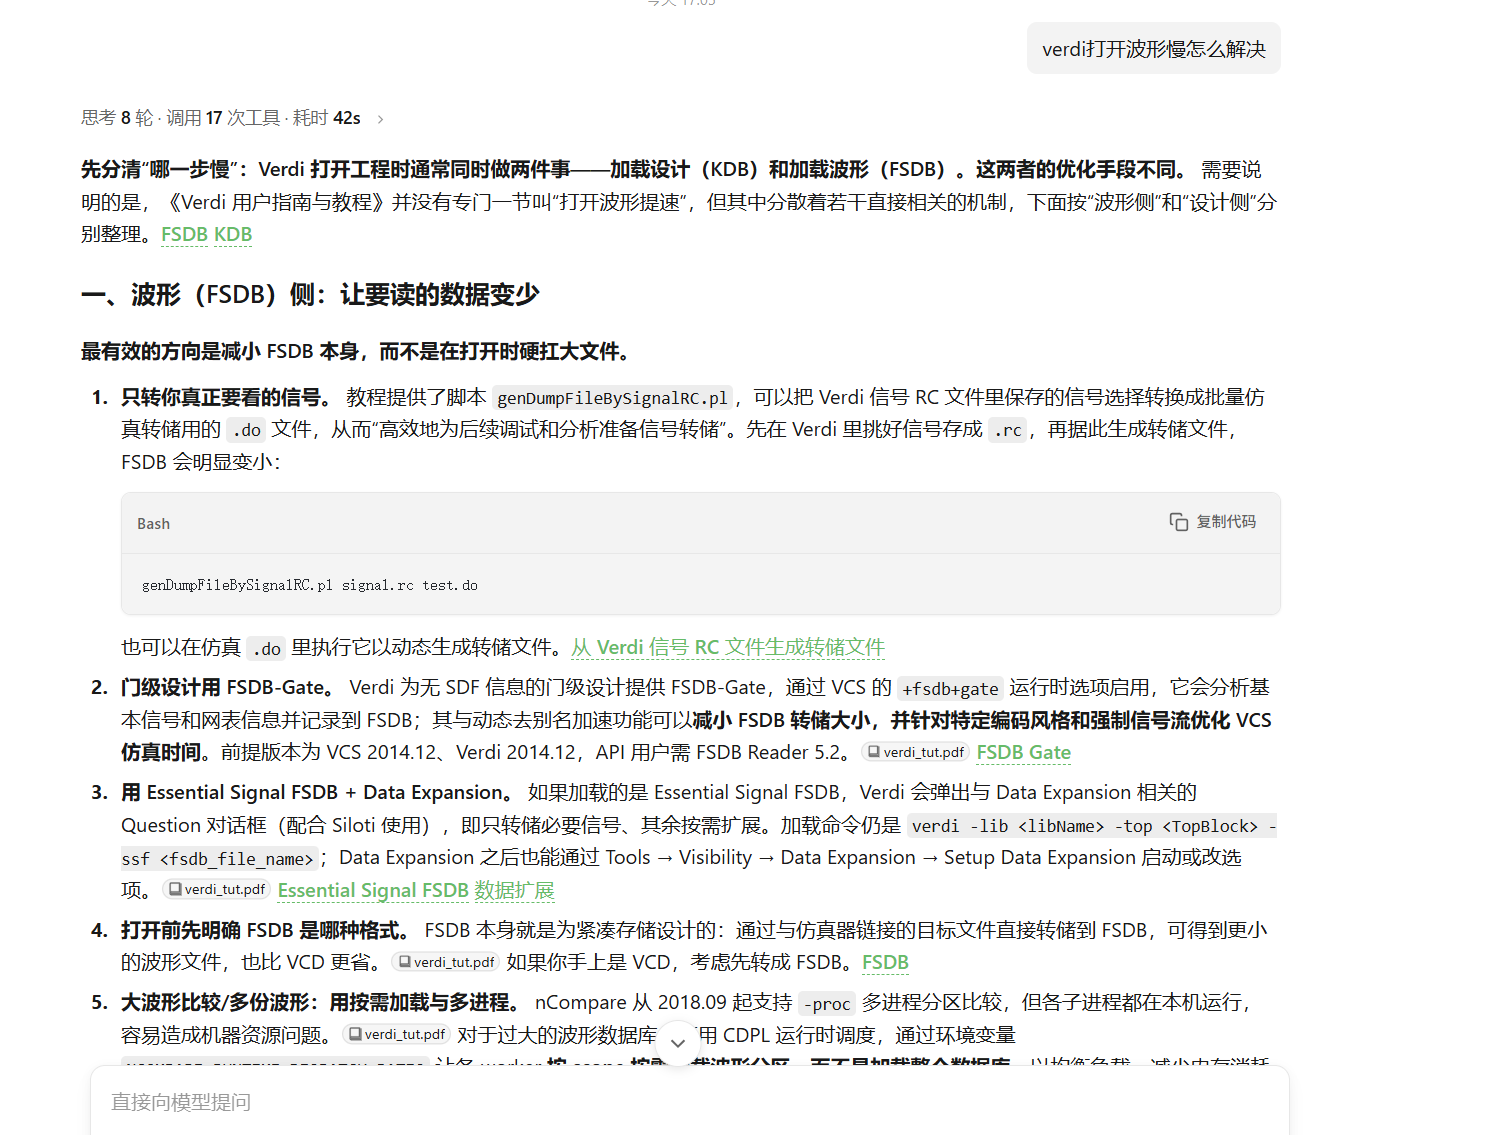
这就是我说“加入 SpyGlass 和 Verdi 后,回答非常好”的具体原因:能围绕导入资料组织参数、连接概念、拆解问题,而且保留继续核对的入口。这是本次试用感受,不是覆盖所有 EDA 问题的准确率评测。
如果准备在研发团队尝试,我建议先选一套常用工具的一组明确版本资料,用日常确实遇到的问题检验,再逐步加入团队已确认的使用经验。能查到原文、能维护知识页、能把答案用回真实工程,这样的知识库才值得持续建设。