大家好啊,我是 jianpeng。
今天和大家聊一下 Qwen-Image-2.1。这次我想和你一起看看:一张已经选好的图,需求变了以后,还能怎么接着改?
一张花朵贴纸已经做好了:橙粉色的字、带笑脸的太阳花,四周围着花叶。现在只改一个需求——把中间的 BLOOM 换成 Qwen-Image,透明背景还要留着。
这件事听起来很小,却很像日常改图。原来的构图挺好,颜色也对,并不想从头再抽一张;只是文案变了,希望沿着这张图继续做。
Qwen-Image-2.1 这次开放权重,官方恰好展示了这样一组例子。我更想顺着这些图看:文字换了,什么被保留下来?参考图多了,模型在组合什么?需要局部修改时,又能不能把位置说清楚?
我也翻了 X 上的提前试用作品,挑了两张有提示词、有具体得失的图放在后面。我们一起对照这些官方和社区样张,看看到底改得怎么样。
先看改字:透明图层可以接着编辑
先看输入与结果。左边是原来的 BLOOM,右边是改字后的 Qwen-Image。
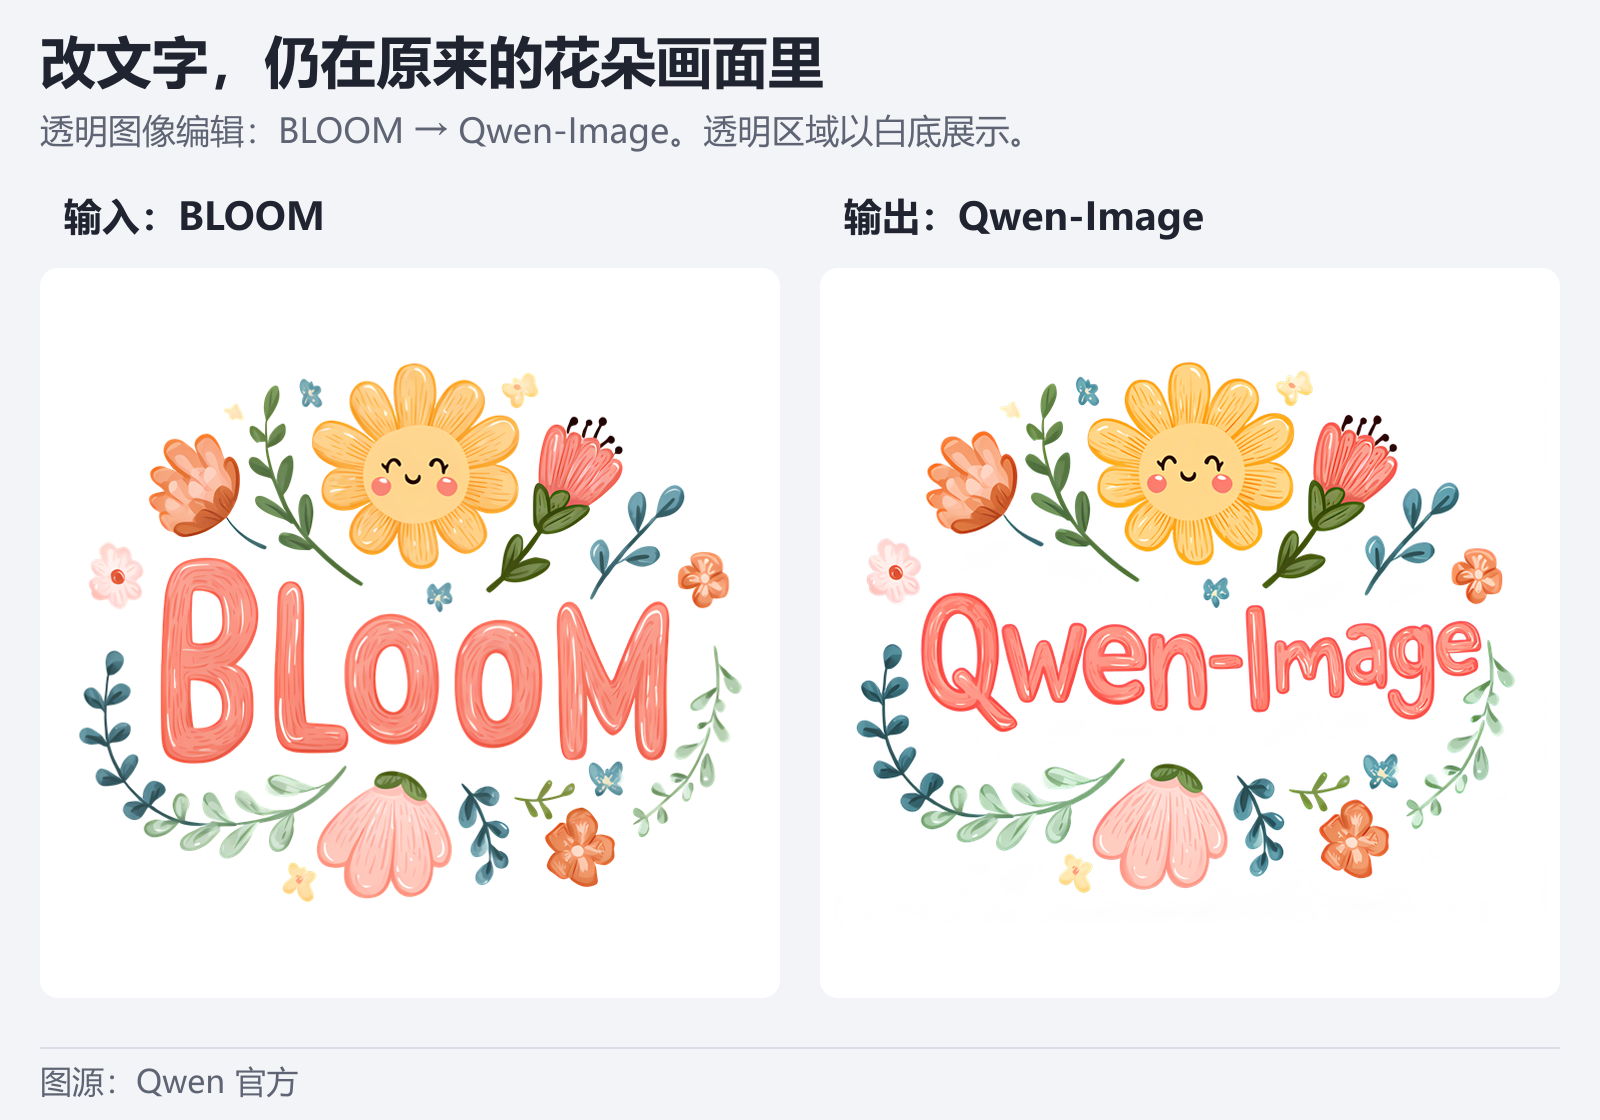
有意思的地方在于,Qwen-Image 比 BLOOM 长得多,右侧的字因此排得更宽、更紧凑。橙粉色、手绘笔触、笑脸太阳花和四周的花叶仍然能对应上。它在处理“换一段字,同时延续这张设计”的要求。
当然,周围图案也能看到重绘,不能把这个例子理解成设计软件里替换文字对象、其余像素原封不动。但作为一份还要继续排版的贴纸,这种修改方向相当直观:你可以带着上一张的视觉基础往下做。
这里还有一个容易被画面盖住的变化:输出可以保留透明通道。 RGB 负责颜色,RGBA 多出的 Alpha 负责透明度。有了这层信息,花叶之间的空隙和画面外侧就可以透出底下的背景,贴纸才方便被放到别的版面上。
我检查了这组官方原始 PNG:改字前后都有 Alpha 通道,也都有实际透明和半透明像素。也就是说,这组文件确实带着透明信息;换成你的素材时,边缘效果还得具体看。
官方把透明生成、透明图编辑和照片抠图放进了同一个模型。这意味着工作可以从文字开始,也可以从已有素材开始。创作者更在意的,往往正是后一半:已经挑中的图,还能不能继续用、继续改。
五张参考图,怎样变成一套穿搭?
接着看一个更复杂的例子。
左侧有五张图:街角的人物、粉色外套、银色鞋、棕色包,还有一顶黑白毛绒帽。右侧把这些参考组合进了同一个画面。

你可以先跟我看三个地方:外套怎样贴合身体,包放在手边是否自然,鞋和帽子又怎样融入照片。这几个地方接不接得上,才是把参考图变成一套穿搭的难点。
右侧结果里,粉色外套披在白色上衣外,棕色包落在手边,银鞋和毛绒帽也进入了同一套造型。场景仍围绕最初人物所在的街角展开。模型需要同时处理物体的身份、大小、透视、遮挡和光线,让几份各自独立的材料形成一张图。
同时,人物的脸部、发型和姿态也明显重绘。这组图能说明多件单品被合进同一画面,不能据此认定人物身份或原姿态被精确保留。
这也是多图输入有吸引力的地方。以前要用一长段文字形容帽子、包和鞋,描述里总会丢失信息;现在可以直接交付参考,让模型看见你指的是哪一件。
官方给出的上限是 10 张参考图。另一个家居案例把空房间与多件家具组合成室内效果:这是同一种思路,只是对象从穿搭变成了空间布置。参考图提供具体材料,生成过程负责把它们放进共同场景。
不过,画面协调与商品精确是两种要求。要拿它做款式讨论、搭配草案,可以先看整体;如果涉及正式商品展示,还要逐件核对纹样、部件和标识。官方挑选的这一张样图,也不能告诉我们每次重试有多稳定。
改哪里,可以直接画给它看
多图解决了“参考什么”,局部编辑则进一步处理“动哪里”。
下面这组图里,输入端用了三种颜色标出不同位置:蓝色对应手表,红色对应头发,绿色对应上衣。修改要求分别是去掉手表、把头发改黑、把衣服换成灰色短袖。
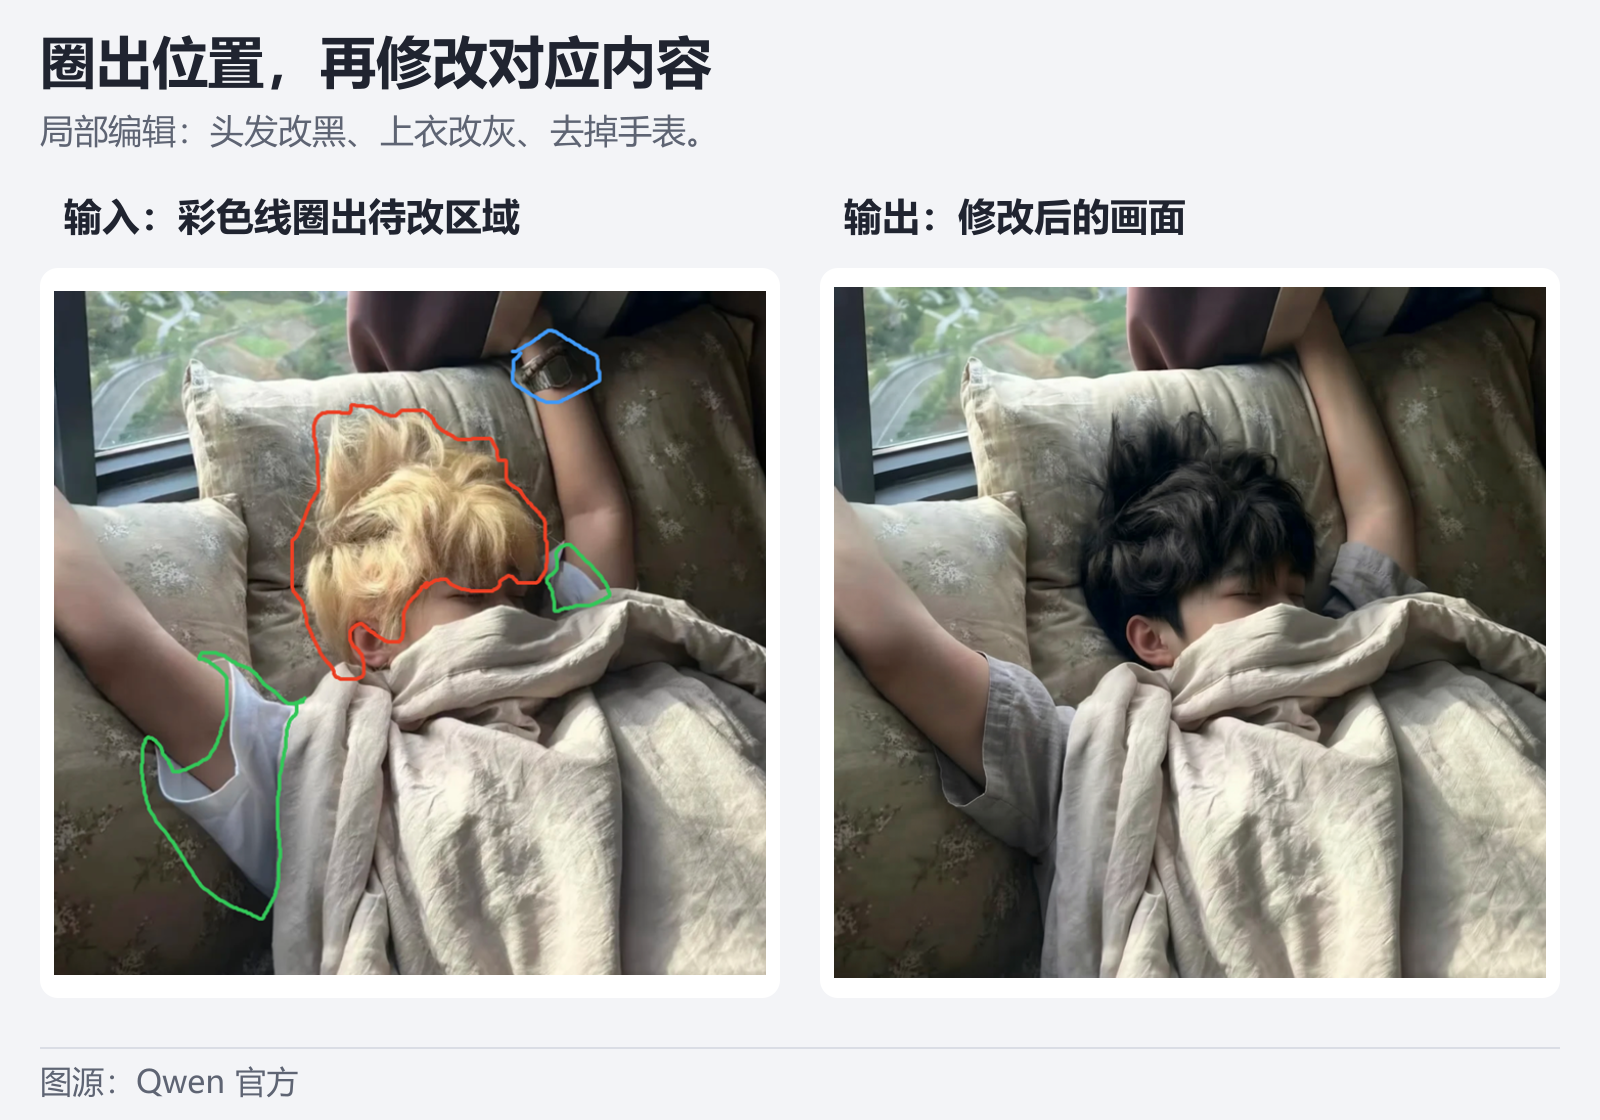
对照右图,三项变化都能直接找到:手腕上的表消失了,金发变成黑发,上衣变成灰色。沙发、窗边和覆盖身体的毯子仍构成原来的画面。
这种交互降低了描述位置的负担。只靠文字,要说清“靠近窗边、抬起来的那只手腕上的表”;有了标记,指令就能和图中的具体区域对应起来。
除了圈选,官方还展示了涂抹与独立掩码。独立掩码的用处也很好理解:一张图保留原始画面,另一张只负责告诉模型哪些地方需要处理,避免标记本身盖住原图细节。
这里我会把预期放准一点:标记能帮我们说清楚改哪里,但它不是图像软件里的像素锁。你要是有一块内容必须原样留下,还是得放大结果,对着原图再看一遍。
X 上这两张图,让我多看了一会儿
除了官方编辑样张,Richard C. Suwandi 在 X 上贴出了一组提前试用作品。他在串帖开头说明采用单次生成,也公开了提示词;主页自述是 Qwen 开发者大使。下面按社区试用分享来看。
先看这张“周一早晨”四格漫画。
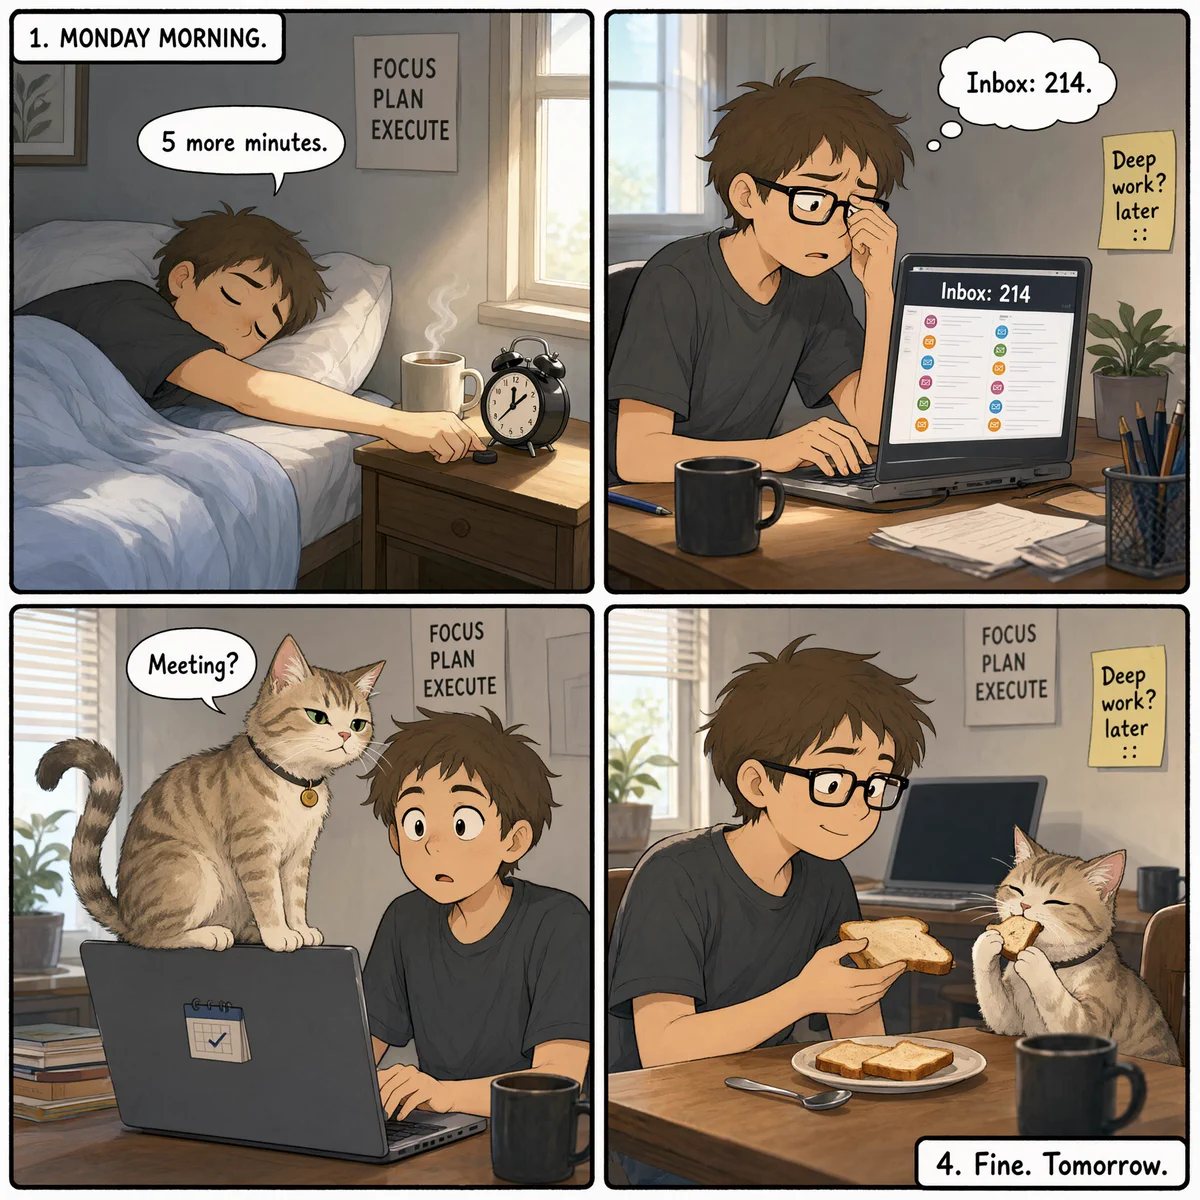
前一格还在赖床,下一格已经对着 214 封邮件发愁,猫又坐到电脑上要“开会”,最后干脆一起吃吐司。四句短文字分别进入对应格子,棕发、深色上衣和室内色调也把故事串了起来。
这比生成一幅单独的插画多了一层要求:四个画面得按顺序讲一件事。
但仔细看,第三格眼镜没了,第四格又回来了;画面还多出了提示词没要求的序号和便签符号。作者也在原帖指出了这些问题。故事能读通,角色细节仍会漂。 如果拿来做连续漫画草稿,这个差别值得记住。
另一张是咖啡知识图。
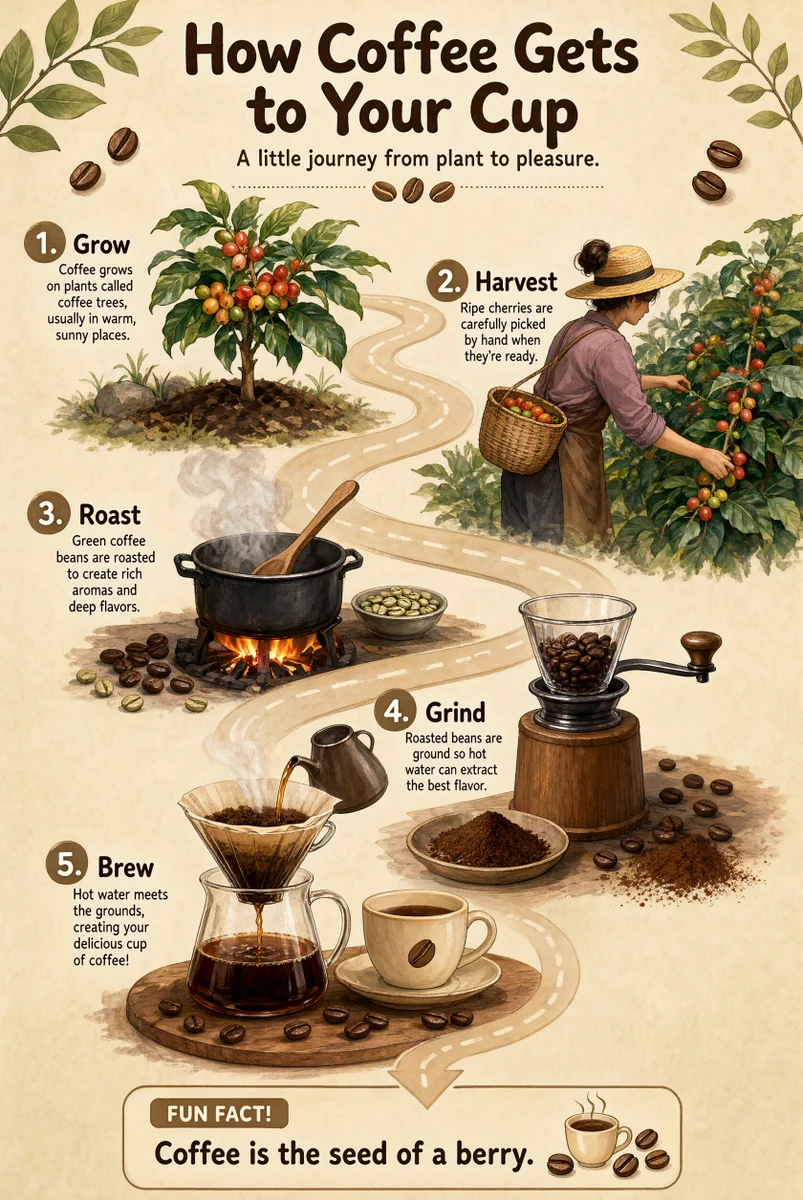
五个步骤沿着一条弯曲小路展开,编号、插图和小段文字各有位置,最后落到杯子和底部提示框。相比孤立地说“文字渲染进步了”,这张图更容易让人想到科普配图、课程提纲和流程海报。
不过,模型也自己加了一行副标题。如果你在找灵感,这行字也许刚好合心意;如果客户已经定了文案,它就是要改回去的地方。还有一点别漏了:字画清楚之后,内容对不对,仍然要我们自己查。
看过这些图,再回到“继续改”
看到漫画里消失的眼镜、知识图里多出的一行字,就更容易理解编辑能力为什么重要:初稿已经有可取之处,接下来最想做的,恰恰是把那几处问题改掉。
透明图解决素材怎样进入别的版面,多图参考补充文字难以完整表达的视觉信息,局部标记则让修改位置更加明确。这几项接在一起,图像模型就能介入更多后续制作环节。
官方也在为多图输入优化推理。简单说,编辑指令和参考图在一次生成过程中通常保持不变,因此可以先计算并缓存相关信息,后续去噪步骤再复用。这个设计与多参考编辑的需求相吻合;实际节省多少时间,还要看硬件、精度和工作流。
至于宣传中的 7B,需要读完整:它指的是视觉生成组件,完整推理还包括 Qwen3-VL 8B 编码器和 VAE。不能直接用“7B”推算整套模型的显存要求。官方架构与使用说明
想试的话,从哪里开始?
只想先看任务形态,可以从 Qwen 官方试玩页进入;已经用 ComfyUI 的读者,直接看 2.1 专属教程,其中提供了文生图与编辑模板。写程序接工作流则可以查 Diffusers 的 QwenImage21Pipeline。
有两件事适合在动手前确认。第一是输出设置:模型支持原生 2K,但 ComfyUI 模板默认约 1 MP,2048 方图约为 4 MP,需要自己选择。第二是许可:公开权重采用 Qwen Research License,模型材料限非商业研究与评估,商业使用需另获许可;托管服务条款和生成物权益也要分别核对。模型许可证
如果让我为这次更新选一个最值得先试的任务,我会选“修改一份已经满意的素材”:例如一张透明贴纸换文字,或一张人物图换上指定配饰。范围很清楚,也容易看出模型到底延续了多少原来的设计。
引用链接:Qwen 官方发布 · 官方 X 贴文 · Richard 的四格漫画 · Richard 的咖啡知识图